ScienceProtect aide l'industrie agroalimentaire à suivre ce que la recherche publie sur les substances, les aliments et leurs effets sur la santé. Le client le résume sur son site : transformer 40 millions d'études scientifiques évaluées par les pairs en signaux exploitables pour la sécurité alimentaire et la nutrition. Je travaille sur ce produit depuis 2024, au sein de l'équipe technique de CheckTheNet, la société qui l'édite. C'est un travail d'équipe, et cette fiche dit précisément ce que j'y ai construit.
En images
Le projet en détail
En 2024, j'ai écrit la majeure partie de l'API de la première plateforme, en Django REST Framework sur PostgreSQL : substances, aliments, publications, comptes utilisateurs et suivi de veille. Elle alimente une application Next.js dont l'interface a été développée par un autre développeur de l'équipe, avec qui j'ai travaillé sur l'intégration.
En 2025, j'ai conçu et développé PubMed API, un service FastAPI entièrement asynchrone placé devant l'API publique de PubMed. Il regroupe les requêtes par lots, met les résultats en cache dans Redis et limite son débit sous le quota du service public, pour que le reste de la plateforme puisse interroger la littérature scientifique sans risque de blocage. Le service expose 25 routes et j'en signe environ deux tiers des commits.
Je contribue ensuite au cœur du produit, Who's Who, un GraphRAG construit en équipe : un graphe de connaissances Memgraph relie substances, maladies, aliments, publications, experts et panels de l'EFSA, l'Autorité européenne de sécurité des aliments. Des pipelines TaskIQ récupèrent les publications de chaque substance, les rattachent aux maladies, puis des agents LLM écrits avec pydantic-ai classent le domaine d'étude, la méthodologie et l'effet observé. Les consignes des agents sont versionnées : quand l'une change, seules les publications concernées sont retraitées. J'ai écrit environ un tiers des commits de ce dépôt, dont les scrapers qui collectent les experts et les avis de l'EFSA.
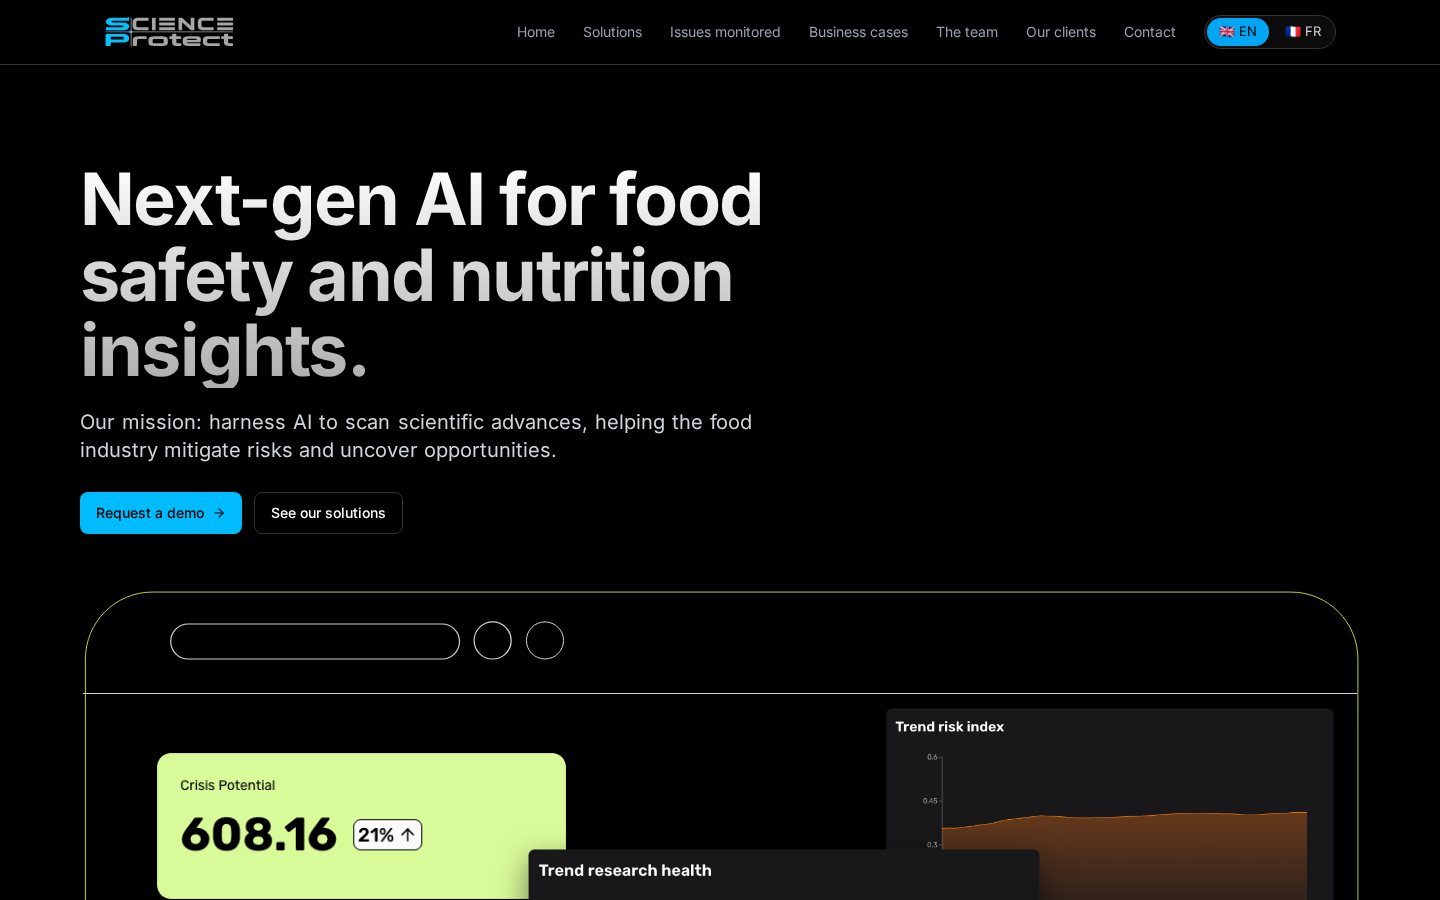
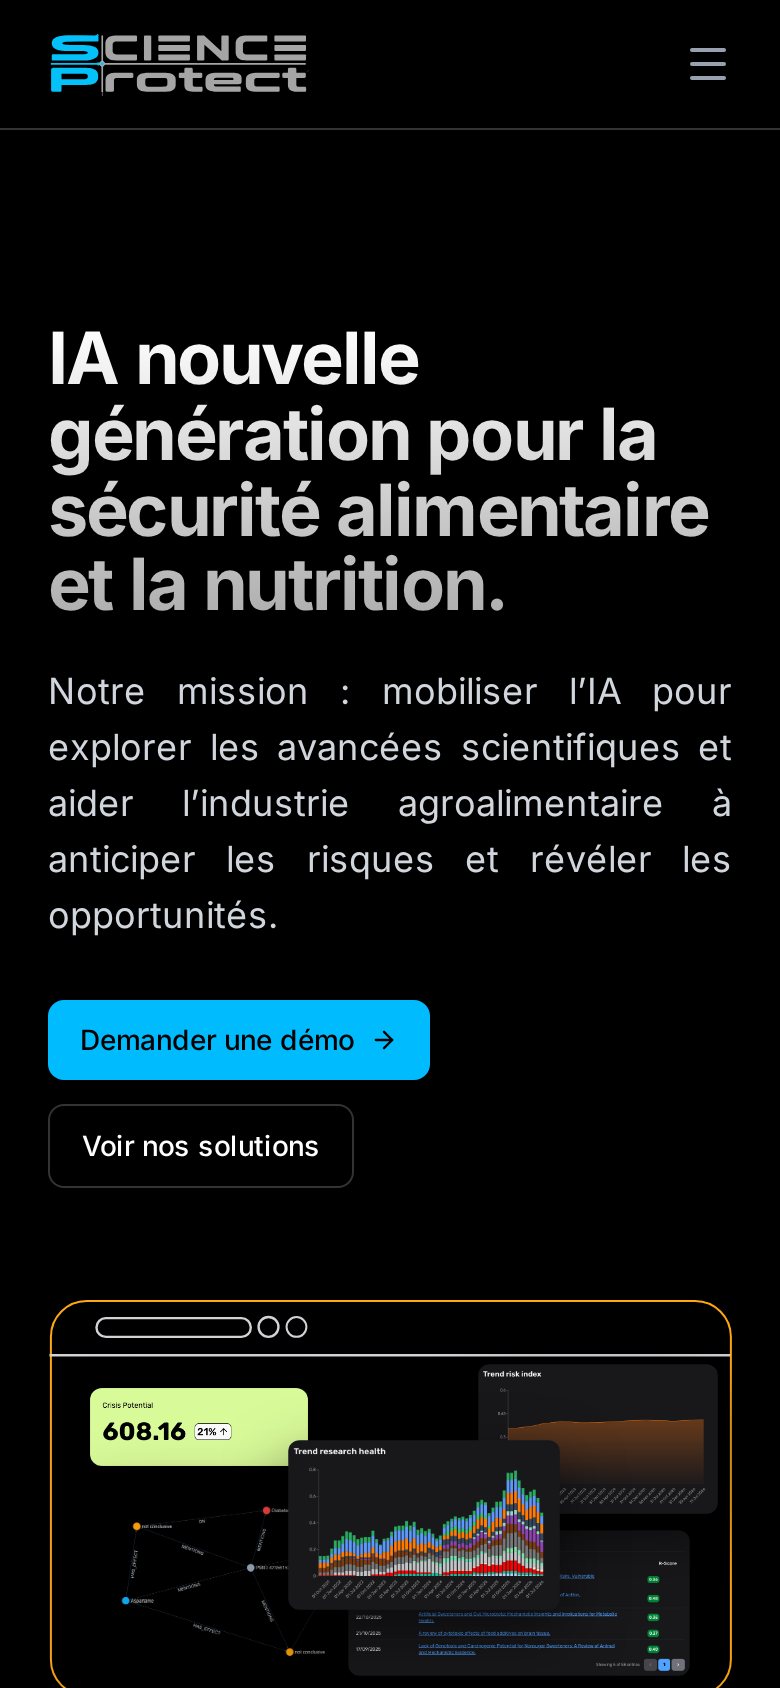
J'ai aussi réalisé, avec l'équipe, le site vitrine bilingue du client en TanStack Start (pages rendues côté serveur, une URL par langue, données structurées) et la petite API FastAPI qui relaie son formulaire de contact par Brevo.
Deux bibliothèques open source sont nées de ce projet : fastapi-object-pagination, pour paginer des réponses FastAPI typées, et async-factory-boy, pour générer des données de test asynchrones. J'ai également contribué en amont à neontology, la bibliothèque Python qui fait le lien entre Pydantic et les bases graphe.